2026년 들어 로컬 AI 모델이 쓸 만한 수준까지 올라오면서, “이걸 내 컴퓨터에서 돌릴 수 있을까”라는 질문이 구체적인 구매 고민으로 이어지고 있습니다. 특히 8월 14일 공개된 Qwen3.8-27B처럼 27B 규모에서 유료 최상위 모델과 견주는 성능이 나오고 Apache 2.0 오픈 라이선스까지 붙자, 기술 커뮤니티의 관심이 한꺼번에 몰렸습니다. 그 흐름 속에서 DGX Spark가 다시 주목받고 있습니다.
DGX Spark는 “개인용 AI 슈퍼컴퓨터”라는 카테고리로 출시된 제품입니다. 국내 유통가가 925만 원 수준(2026년 8월 기준, 유통사별 상이)인 만큼 판단을 잘못 내리면 실수 비용이 큰 제품입니다. 가격, 가능한 작업, 본전 계산, 그리고 사기 전에 확인해야 할 조건을 순서대로 정리합니다.
DGX Spark는 어떤 컴퓨터인가
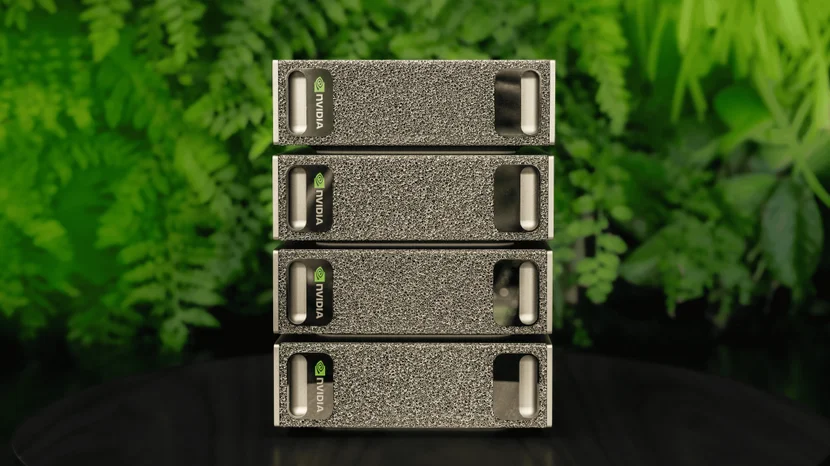
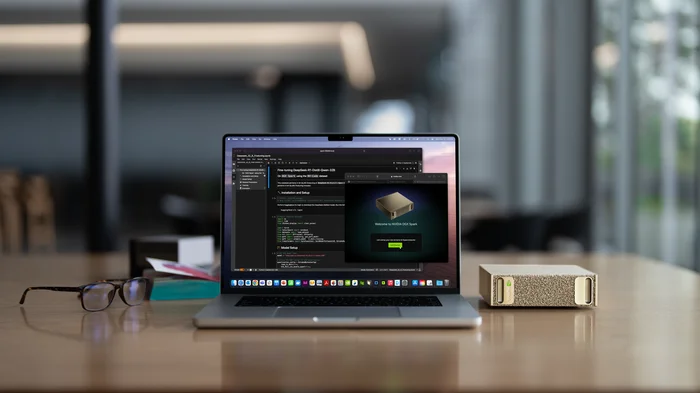
DGX Spark는 NVIDIA GB10 Grace Blackwell 슈퍼칩을 탑재한 소형 데스크톱입니다. Arm 기반 CPU(20코어)와 Blackwell GPU를 하나의 패키지에 결합하고, 128GB LPDDR5X 메모리를 CPU·GPU가 공유합니다. 크기는 150×150×50.5mm, 무게는 1.2kg으로 실제 손에 들면 작은 외장 SSD 케이스보다 조금 큰 정도입니다. 전원 어댑터는 240W입니다.
이 제품을 “고성능 PC를 샀다”고 이해하면 나중에 실망합니다. DGX Spark는 GPU가 들어간 PC가 아니라 로컬 AI 개발을 위한 책상 위 AI 시스템에 가깝습니다. OS는 Ubuntu 24.04 기반 DGX OS이고 윈도우는 지원하지 않습니다. 게임, 오피스, 윈도우 전용 소프트웨어를 쓰려고 사는 제품이 아닙니다.
흔히 언급되는 “1페타플롭 FP4 AI 성능”은 4비트 연산 기준의 수치입니다. 실제 추론 속도는 이 숫자가 아니라 메모리 대역폭(273GB/s)이 결정합니다. 대형 언어 모델의 토큰 생성 속도는 연산 능력보다 얼마나 빠르게 데이터를 메모리에서 읽어오는지에 달려 있기 때문입니다. 이 점은 나중에 실측 수치를 볼 때 기준이 됩니다.
| 항목 | DGX Spark 스펙 |
|---|---|
| 칩 | GB10 Grace Blackwell (Arm CPU 20코어 + Blackwell GPU) |
| 메모리 | 128GB LPDDR5X (CPU·GPU 통합, 대역폭 273GB/s) |
| 저장장치 | M.2 2242 SSD 4TB (교체 가능) |
| OS | DGX OS (Ubuntu 24.04 기반, CUDA 13.0) — 윈도우 미지원 |
| 포트 | USB-C 20Gbps×3, HDMI 2.1a, 10GbE, QSFP×2(최대 200Gbps), Wi-Fi 7 |
| 전원 | 240W 어댑터 |
| 크기·무게 | 150×150×50.5mm, 1.2kg |
| 출시 | 2025년 10월 15일 글로벌 출시 |
한국에서 사려면 — 가격과 구매 경로
DGX Spark는 2025년 10월 15일 글로벌 출시와 함께 국내 예약 주문이 개시됐습니다. 2026년 8월 현재 국내에서는 엑스디노드(노드몰), MDS Tech, BNINC, MKISCORE, 리더스시스템즈, 퀀텀브릭스 등 여러 유통사를 통해 구매할 수 있습니다. 유통사별로 물량 상황과 배송 시점이 다르므로, 구매 전 직접 확인이 필요합니다.
가격 차이가 큰 부분입니다. 국내 유통사 기준 128GB·4TB 모델은 2026년 현재 약 925만 원 선(판매처별 상이, 구매 전 확인 필요)입니다. 미국 MSRP는 2026년 2월 $3,999에서 $4,699로 인상됐으며, 환율 1,400원 기준으로 단순 환산하면 약 660만 원입니다. 차액이 265만 원 이상으로, 국내 정식 유통가가 상당히 높은 것이 현실입니다. NVIDIA는 가격 인상 이유로 “업계 전반의 메모리 공급 제약”을 공식 발표했으며 하드웨어 변경은 없었습니다.
직구도 선택지이지만 단순히 싸다고 판단하기 어렵습니다. 개인 수입 한도를 초과하므로 관세와 부가세가 부과되고, 국제 배송비도 붙습니다. 보증 및 AS는 국내 정식 유통사를 통하는 경우보다 어렵습니다. 총비용과 AS 경로를 함께 계산한 뒤 선택해야 합니다.
DGX Spark로 가능한 모든 것
128GB 통합 메모리가 이 제품의 핵심 경쟁력입니다. 일반 데스크톱 GPU(RTX 4090 기준 24GB VRAM)로는 메모리에 올릴 수도 없는 대형 모델을 로컬에서 실행할 수 있다는 점이 다릅니다. 다만 “올라간다”와 “쾌적하게 돌아간다”는 다릅니다. 속도는 메모리 대역폭 273GB/s가 한계를 정합니다.
로컬 LLM 추론 실측 속도
현재 커뮤니티에서 가장 많이 구동해보는 모델은 Qwen3.8-27B입니다. 2026년 8월 14일 공개된 이 모델은 27B 밀집 파라미터 구조에 멀티모달(이미지·영상 입력), 262K 컨텍스트를 지원하며 Apache 2.0 오픈 라이선스입니다. Q4_K_M 양자화 기준 약 17GB 수준이라 24GB 그래픽카드에서도 실행되지만, DGX Spark에서는 전체 메모리를 활용한 더 큰 양자화 설정으로 돌릴 수 있습니다. 커뮤니티 실측 기준 SGLang + NVFP4 구성에서 약 34~38토큰/초, 기본 llama.cpp·vLLM 구성에서는 약 20~27토큰/초 수준이 보고되고 있습니다. “추론을 지나치게 길게 하는 경향”이 있다는 점도 실사용자들이 공통으로 지적합니다.
더 큰 MoE(Mixture of Experts) 모델로 가면 DGX Spark 1대의 한계가 드러납니다. DeepSeek V4 Flash(총 284B 파라미터 MoE, 활성 13B)는 1대에서 약 26토큰/초, QSFP로 연결한 2대 클러스터에서는 약 82토큰/초까지 올라갑니다. 커뮤니티에서 “2대 구성이 최적 지점”이라는 평이 나오는 이유입니다. 3대 구성에서는 GLM-5.2(비전 포함)를 NVFP4·AQLM 2비트 혼합 양자화로 7,440억 파라미터를 272GB에 수용하는 실험도 보고됩니다. Qwen3.8-2.4T(총 2.4조 파라미터, 활성 95B)는 수백 GB가 필요해 단독으로는 실행 불가이며 멀티 노드 대상입니다.
| 모델 | 구성 | 속도(추정) |
|---|---|---|
| Qwen3.8-27B | 1대, SGLang+NVFP4 | 약 34~38토큰/초 |
| Qwen3.8-27B | 1대, llama.cpp·vLLM | 약 20~27토큰/초 |
| DeepSeek V4 Flash | 1대 | 약 26토큰/초 |
| DeepSeek V4 Flash | 2대 클러스터 | 약 82토큰/초 |
| GLM-5.2 (혼합 양자화) | 3대 클러스터 | 약 25토큰/초 |
위 수치는 모두 특정 모델·양자화 설정·컨텍스트 길이 조건에서 측정된 값입니다. 컨텍스트가 길어질수록 속도는 떨어지며, 구성과 소프트웨어 버전에 따라 편차가 있습니다.
이미지·영상 생성
1024×1024, 50스텝 기준 이미지 생성 벤치에서 SD 3.5 medium은 34초(22GB), FLUX.1-dev는 111초(95GB)입니다. FLUX.1-dev처럼 95GB를 요구하는 모델은 일반 데스크톱 GPU로는 아예 실행할 수 없는데, DGX Spark에서는 128GB 덕분에 올라갑니다. 다만 “가장 빠른 생성 머신”은 아닙니다. 해외 리뷰의 총평을 요약하면 “VRAM 제약 없이 무엇이든 실행할 수 있는 머신, 대형 모델 탐색·프로토타이핑용”이라는 평가가 일관됩니다. 영상 생성은 ComfyUI를 통해 Wan, HunyuanVideo, Cosmos 워크플로우를 공식 지원합니다.
파인튜닝·에이전트·개발 환경
소규모 LoRA 파인튜닝, 실험적 모델 검증, RAG 파이프라인 구축, AI 에이전트 운영은 현실적으로 가능한 작업 범위입니다. PyTorch, Docker, Jupyter 컨테이너 환경이 사전 탑재돼 있고, NVIDIA AI 소프트웨어 스택이 DGX OS에 포함됩니다. ConnectX-7 NIC(QSFP 2개, 최대 200Gbps)를 통한 멀티 노드 클러스터링은 개인용 제품에서 사실상 유일한 구성입니다. 단, 수일 단위의 대형 사전학습이나 H100급 분산 학습은 이 제품의 설계 범위 밖입니다.
AI 구독료·클라우드와 비교하면 — 본전 계산
DGX Spark를 “AI 구독료 대신”이라는 명목으로 구매하는 경우, 숫자가 생각보다 잘 맞지 않습니다. ChatGPT·Claude·Gemini 같은 유료 AI 구독을 3개 동시에 유지한다고 가정할 때 월 약 9만 원, 연 약 108만 원입니다(요금제 변동에 따라 현재 기준 확인 필요). 국내 유통가 925만 원 기준으로 단순 계산하면 본전에 약 8.6년이 걸립니다. 미국 정가($4,699, 환율 1,400원 기준 약 660만 원)로도 6.1년입니다. 게다가 로컬 오픈 모델은 최신 유료 프론티어 모델과 품질 차이가 존재하므로, 비용만 계산해도 “대체”라고 보기 어렵습니다.
클라우드 GPU 임대와 비교하면 상황이 더 복잡합니다. RTX 4090 24GB는 해외 GPU 마켓플레이스 기준 $0.34~$0.69/시간 수준입니다(2026년 7월 기준, 플랫폼·구성별 상이). 하루 4시간 사용을 기준으로 단순 계산하면 월 비용은 수만 원 수준이고 본전까지 10년 이상이 나옵니다. 단, 이 비교에는 맹점이 있습니다. RTX 4090은 24GB VRAM이라 128GB가 필요한 대형 모델을 실행할 수 없습니다. 정확한 비교는 “같은 작업”을 기준으로 해야 합니다.
| 비교 대상 | 연간 비용(추정) | 본전 기간(국내가 925만원) |
|---|---|---|
| AI 구독 3개 | 약 108만원 | 약 8.6년 |
| AI 구독 1개 | 약 36만원 | 약 25년 이상 |
| 클라우드 RTX 4090 (하루 4시간) | 약 68만원 | 약 13년 |
| 클라우드 RTX 4090 (하루 8시간) | 약 137만원 | 약 6.8년 |
| 클라우드 H100 PCIe (하루 8시간) | 약 1,330만원 | 약 0.7년 |
위 계산은 모두 전제 조건이 있는 추정치입니다. 클라우드 요금은 플랫폼·시점·구성에 따라 달라지고, AI 구독 요금도 요금제 변동 가능성이 있습니다. 본전 계산의 의미는 정확한 숫자보다 구조입니다. 상시·대용량·장기로 클라우드 H100급을 쓰는 워크로드라면 DGX Spark 구매가 경제적으로 유리한 시점이 올 수 있지만, 가끔 사용하거나 24GB GPU로 충분한 작업이라면 클라우드나 구독이 훨씬 효율적입니다. 전기요금은 하루 4시간 부하 사용 시 월 수천 원에서 1만 원대 추가가 예상되고(전원 240W 기준 추정, 가정 요금제·누진 구간에 따라 다름), 24시간 유휴 구동 시 월 수천 원 내외로 보면 됩니다.
이 컴퓨터가 진짜 잘하는 것
DGX Spark가 가장 명확한 가치를 발휘하는 영역은 데이터 프라이버시입니다. 민감한 사내 문서, 연구 데이터, 개인 정보가 포함된 워크로드를 클라우드나 유료 API로 보내지 않고 기기 안에서 처리할 수 있습니다. 의료, 법률, 보안, 연구처럼 데이터 외부 전송 자체가 규제나 계약으로 제한된 환경에서는 이 점이 결정적입니다.
사용량 제한이 없다는 것도 실질적인 장점입니다. 유료 API는 토큰 단위로 과금되고, 구독 서비스는 월 사용 한도가 있습니다. DGX Spark는 전기만 공급되면 하루 24시간, 월 수천만 토큰을 추가 비용 없이 처리합니다. AI 에이전트처럼 대량 배치 처리가 반복되는 워크로드에서는 이 구조가 경제적으로 유리해집니다. 오프라인 동작이 가능하다는 점도 인터넷 연결이 불안정한 환경에서 의미가 있습니다.
소프트웨어 스택 측면에서는 성숙한 CUDA 생태계가 그대로 사용됩니다. DGX OS에는 NVIDIA AI 소프트웨어 스택이 사전 탑재돼 있어 초기 개발 환경 설정 부담이 적습니다. ConnectX-7 NIC의 QSFP 포트 2개(최대 200Gbps)를 통한 멀티 노드 클러스터링은 개인 구매 가능한 제품 중 사실상 유일한 구성으로, 2~4대를 묶어 더 큰 모델 실험을 할 수 있습니다.
빠지기 쉬운 비용과 한계
초기 비용이 높은 것은 알고 사는 경우가 많지만, 업그레이드가 불가하다는 점은 간과하기 쉽습니다. 128GB 메모리는 칩에 통합된 구조라 용량 확장이 불가능합니다. 1~2년 뒤 더 큰 모델이 나왔을 때, 메모리가 부족하면 교체 없이 해결할 방법이 없습니다. 저장장치(M.2 2242 SSD)만 교체 가능합니다.
윈도우 미지원은 단순한 불편이 아닌 구조적 제약입니다. 터미널, 컨테이너, 리눅스 명령어에 익숙하지 않다면 기본 설정 단계에서 막힐 수 있습니다. x86 아키텍처를 전제하는 바이너리나 Windows 전용 프로그램은 실행이 안 됩니다. 게임은 “게임 자체가 안 된다”는 것이 아니라, GeForce 드라이버와 윈도우가 없어 게이밍 PC처럼 쓰는 것이 불가하다는 의미입니다.
세대 리스크도 고려해야 합니다. DGX Spark는 2025년 10월 출시로 2026년 8월 기준 약 10개월이 지난 제품입니다. 2026년 가을 출시가 예정된 RTX Spark는 윈도우 AI PC(소비자용 소형 폼팩터)로 포지셔닝이 다르지만, 신제품 등장으로 DGX Spark의 “최신 제품” 이미지는 약해질 수 있습니다. GB10의 후속 칩이나 가격 조정 여부는 현재 확인 필요 상태입니다. 추론 속도 측면에서도 플래그십 데스크톱 GPU나 데이터센터 GPU 대비 메모리 대역폭(273GB/s)이 병목이 되어 속도에서 뒤집니다. 용량이 필요해서 사는 제품이지, 가장 빠른 선택지가 아닙니다.
사기 전에 확인할 체크리스트
이 체크리스트는 구매를 막으려는 것이 아니라, 구매 후 후회를 줄이기 위한 것입니다. 아래 항목을 먼저 따진 뒤 결정하세요.
| 확인 항목 | 판단 기준 |
|---|---|
| 내 작업이 128GB 로컬 메모리가 필요한가 | 실행할 모델의 메모리 요구량 확인 (24GB GPU로 가능하면 DGX Spark 필요 없음) |
| 하루 몇 시간 쓸 것인가 | 가끔 사용이면 클라우드가 효율적, 상시 구동이면 본전 계산 개선 |
| 소프트웨어 호환성 | 사용할 스택이 Arm Linux에서 동작하는지 확인 (PyTorch, Docker, 자체 환경) |
| 전력·네트워크 환경 | 240W 전원 확보, 클러스터 구성 시 QSFP 케이블·스위치 별도 필요 |
| A/S·보증 경로 | 유통사 보증 정책 확인, 직구 시 AS 어려움 인지 |
| RTX Spark를 기다릴 이유가 있는가 | 윈도우·게임·일반 작업이 목적이면 가을 출시 RTX Spark가 더 적합할 수 있음 |
| 가격 비교 | 국내 유통사 여러 곳 + 직구 총비용(관세 포함) 비교 |
AI 구독을 몇 개 유지 중인 분이라면 용도별 AI 구독 선택 글에서 실제로 필요한 서비스가 무엇인지 먼저 점검해 보시길 권합니다.
자주 묻는 질문
Q. 게임도 할 수 있나요?
Q. 해외 직구로 사는 게 낫지 않나요?
Q. RTX Spark가 나오면 DGX Spark는 구형이 되는 건가요?
Q. 전기세는 얼마나 나오나요?
Q. AI 구독료 대신 사도 되나요?
Q. 일반 노트북·PC와 뭐가 다른가요?
✅ 이런 분께 맞습니다
- 로컬 AI 개발·연구가 실제 주요 업무이며 128GB 메모리가 필요한 개발자
- 민감 데이터·연구 데이터를 외부로 보내지 않고 처리해야 하는 환경
- AI 에이전트·배치 추론처럼 상시·대용량 워크로드를 장기 운영할 계획이 있는 사용자
- 리눅스·컨테이너 환경에 익숙하고 소프트웨어 호환성 확인이 된 개발자
- 클라우드 H100급을 장시간 사용 중이어서 로컬 구매가 비용상 유리한 경우
❌ 이런 분께는 맞지 않습니다
- AI 구독료나 클라우드 비용을 아끼려는 목적으로 구매를 고려 중인 경우
- 윈도우 소프트웨어, 게임, 일반 업무 작업이 주 용도인 경우
- 가끔 AI 모델을 써보는 수준이거나 24GB GPU로 충분한 작업을 하는 경우
- 리눅스·터미널 환경에 익숙하지 않고 즉시 사용 가능한 환경이 필요한 경우
- 가을 이후 RTX Spark나 차세대 제품 출시를 기다릴 수 있는 여유가 있는 경우
※ 본 글은 실사용자 후기 및 공개된 정보를 바탕으로 작성되었습니다. 가격·스펙은 변동될 수 있으며, 구매 전 최신 정보를 직접 확인하시기 바랍니다. | cashup24.com